L'essentiel
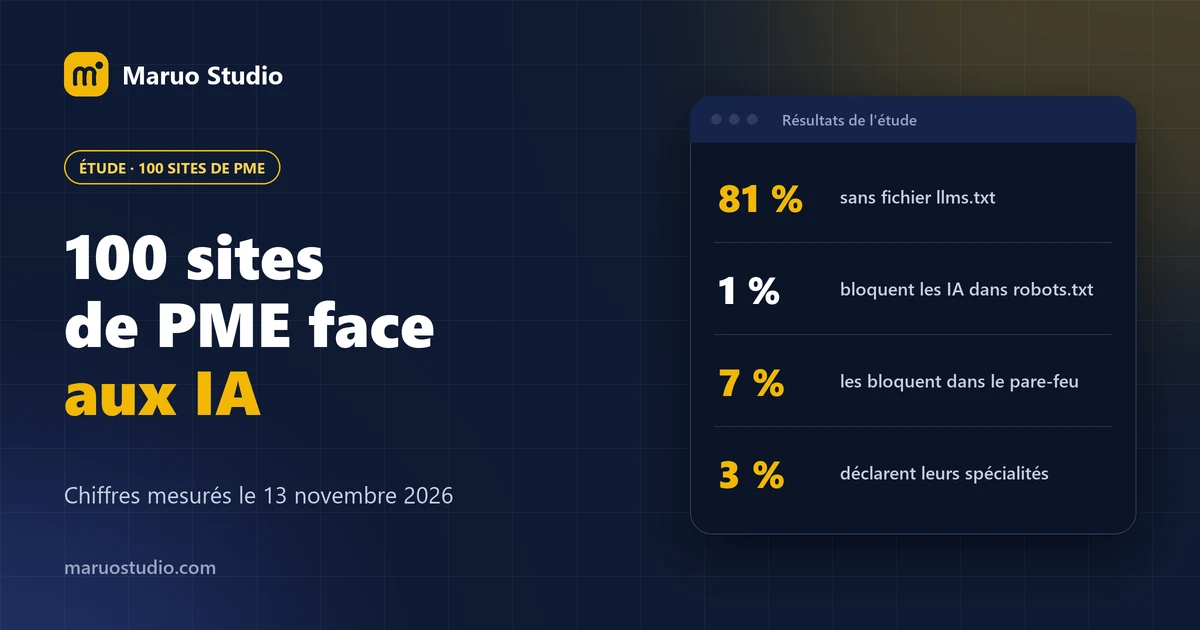
- Score moyen : 79,4 sur 100. La plupart des PME ne sont pas « invisibles » pour les IA. Il leur manque une ou deux pièces, pas tout.
- 81 % n'ont pas de fichier llms.txt. La moitié des sites (50 sur 100) ont tout le reste en ordre et plafonnent à 85 sur 100 à cause de ce seul fichier.
- Le robots.txt n'est presque jamais en cause : 1 site sur 100 y bloque un robot d'IA.
- Le vrai blocage est caché dans le serveur : 7 sites au robots.txt ouvert refusent quand même GPTBot et ClaudeBot. Aucun ne refuse le robot de ChatGPT recherche.
- 3 % seulement décrivent leurs spécialités dans leurs données structurées.
Pourquoi cette étude
Vos clients ne tapent plus seulement trois mots dans Google. De plus en plus, ils demandent à ChatGPT, Perplexity ou Copilot : « Quel cabinet comptable à Lyon pour une création d'entreprise ? » Pour qu'une IA vous recommande, une première condition doit être remplie : ses robots doivent pouvoir lire votre site.
On lit partout que « la majorité des PME sont invisibles pour les IA ». Nous voulions le vérifier, avec des chiffres plutôt qu'une impression. Nous avons donc pris 100 sites de PME qui sortent en tête de recherches commerciales, et nous les avons passés dans notre vérificateur llms.txt gratuit, le même jour, avec le même barème.
Résultat : l'idée reçue est fausse dans sa forme, mais juste sur le fond. Les PME ne ferment pas la porte aux IA. Elles oublient de leur laisser un plan. Et quand elles la ferment, c'est sans le savoir.
Méthode : comment nous avons mesuré
L'échantillon
100 sites, 25 par secteur, choisis parce qu'ils sont des cibles naturelles du référencement local ou B2B :
- Cabinets d'expertise comptable : Lyon, Toulouse, Nantes, Bordeaux et Lille.
- Agences immobilières indépendantes : Lyon, Nantes, Montpellier et Rennes.
- Éditeurs français de logiciels pour PME : gestion de chantier, comptabilité, RH et CRM.
- Artisans du bâtiment : plombiers à Lyon, couvreurs à Nantes, entreprises de rénovation à Toulouse, électriciens à Bordeaux.
Les sites viennent des premiers résultats d'une recherche web sur des requêtes commerciales (par exemple « cabinet expert comptable Lyon » ou « logiciel gestion chantier BTP »). Nous avons écarté les annuaires, les comparateurs, les grands réseaux nationaux et les pages d'agences de franchise : seuls restent des sites d'entreprises indépendantes. Un site hors service a été remplacé par le résultat suivant.
La mesure
Chaque site est passé dans notre vérificateur le 13 novembre 2026, en moins de dix minutes. Le barème est celui qui est publié sur la page de l'outil :
| Critère | Points |
|---|---|
| Accès des 6 robots d'IA principaux dans le robots.txt (GPTBot, OAI-SearchBot, PerplexityBot, ClaudeBot, Google-Extended, Bingbot) | 30 |
| Page d'accueil accessible et indexable | 20 |
| Données structurées JSON-LD sur l'accueil | 15 |
| Fichier llms.txt présent et bien formé | 15 |
| Sitemap XML trouvable | 10 |
| Balise title et meta description | 10 |
Nous avons ajouté un contrôle que l'outil ne fait pas encore : demander la page d'accueil en se présentant successivement comme un navigateur, puis comme GPTBot, OAI-SearchBot, PerplexityBot et ClaudeBot. Si le navigateur reçoit la page et un robot d'IA reçoit un refus, quelque chose filtre les IA avant le robots.txt. Chaque refus a été vérifié lors d'un second passage, lent, site par site. Seuls les refus constatés deux fois sont comptés.
Les résultats sont publiés de façon agrégée. Nous ne citons aucune entreprise en mauvais exemple.
Résultat 1 : un score moyen de 79 sur 100
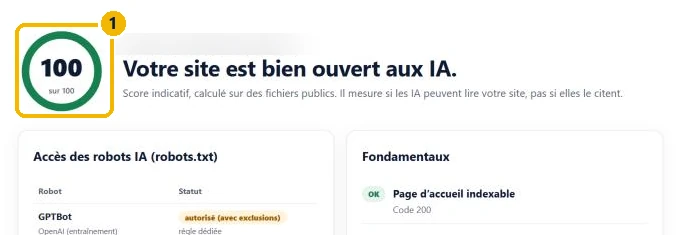
Sur 100 sites, le score moyen est de 79,4 sur 100, et la médiane de 85. 13 sites obtiennent 100 sur 100.
Répartition des 100 sites par niveau
Paliers du vérificateur, en nombre de sites
C'est plus haut que ce qu'on lit souvent. Il faut le dire clairement : notre barème est volontairement accessible. Un site sans llms.txt peut atteindre 85, car le fichier ne compte que pour 15 points. Le score dit si les fondations sont là. Il ne dit pas si ChatGPT vous recommande.
L'immobilier ferme la marche
Score moyen par secteur
Sur 100, 25 sites par secteur
Les agences immobilières sont nettement en retrait : 5 sur 25 sont sous la barre des 45. La cause n'est presque jamais le robots.txt. Elle se trouve dans la façon dont certains sites d'agences sont hébergés, comme on le verra au résultat 3.
Les artisans, eux, s'en sortent bien. La plupart de leurs sites tournent sur WordPress avec une extension SEO, qui produit par défaut un sitemap, des balises et un minimum de données structurées.
Résultat 2 : le llms.txt, grand absent (81 %)
19 sites sur 100 publient un fichier llms.txt. Les 81 autres n'en ont pas. C'est l'écart le plus net de toute l'étude, et c'est lui qui explique le chiffre le plus frappant : 50 sites sont bloqués à exactement 85 sur 100. Robots autorisés, accueil indexable, sitemap, balises, données structurées : tout y est, sauf ce fichier.
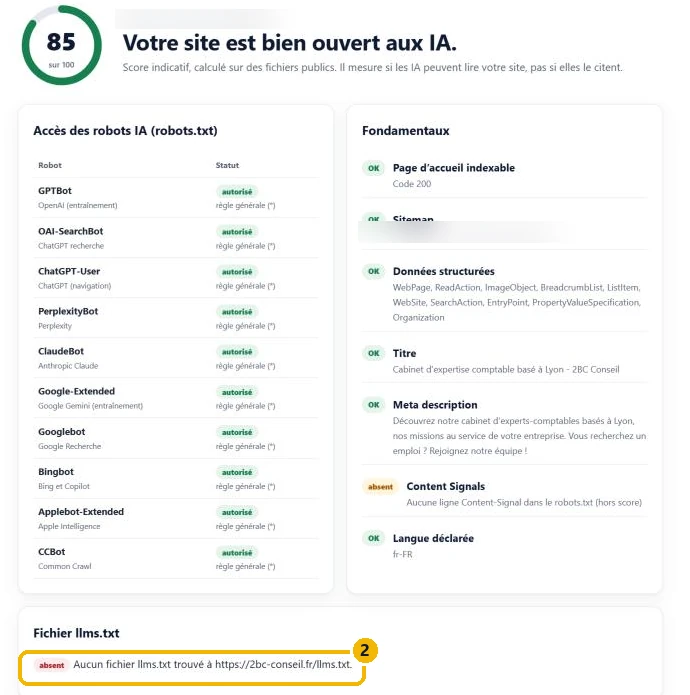
Sites avec un fichier llms.txt, par secteur
Sur 25 sites par secteur
Les éditeurs de logiciels ont pris de l'avance, ce qui est logique : le llms.txt est né dans le monde de la documentation technique, et leurs équipes suivent ces sujets. Les cabinets, les agences et les artisans sont loin derrière.
Quand le fichier existe, il est souvent bâclé
- 4 des 19 fichiers sont incomplets : il leur manque le résumé ou les liens prévus par le format llms.txt.
- Plusieurs ont visiblement été générés automatiquement sans relecture : un titre qui reprend l'adresse du site au lieu du nom de l'entreprise, des caractères mal encodés (
&au lieu de « & »), un nom d'entreprise collé en un seul mot. - 10 sites répondent à l'adresse
/llms.txtpar une page HTML et un code 200, au lieu d'une erreur 404 ou d'un fichier texte. Pour un robot, c'est un faux fichier. - Un seul site publie un
llms-full.txt, une convention qui ne fait pas partie de la proposition officielle.
Petite observation sur les outils : les 3 sites Wix de l'échantillon ont tous un llms.txt et obtiennent 100 sur 100, et 3 des 4 sites Webflow en ont un. Sur WordPress, seulement 7 sur 44. L'échantillon Wix et Webflow est trop petit pour en tirer une règle, mais la tendance est cohérente : quand la plateforme génère le fichier, il existe. Quand il faut l'activer ou l'écrire, il manque.
Le llms.txt n'est pas un levier de classement Google : Google indique qu'aucun fichier spécial n'est nécessaire pour ses fonctionnalités d'IA. Mais il est lu par des agents et des outils d'IA. Avec 81 % de concurrents qui n'en ont pas, c'est l'avantage le moins cher à prendre. Nous détaillons le format dans notre guide llms.txt : exemple complet et 7 erreurs.
Résultat 3 : le blocage n'est pas dans le robots.txt, il est dans le pare-feu
C'est le résultat le plus important de l'étude, et le plus contre-intuitif.
Dans les robots.txt, 1 seul site sur 100 interdit un robot d'IA (en l'occurrence GPTBot, ClaudeBot, Google-Extended et CCBot, les robots d'entraînement et de Claude). 92 sites ont un robots.txt lisible, et seulement 6 y écrivent une règle dédiée à un robot d'IA. Autrement dit : presque personne ne bloque les IA volontairement.
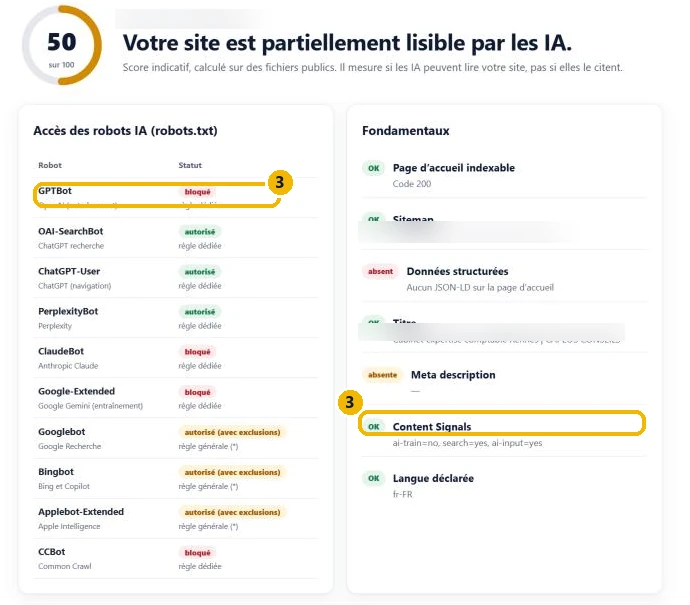
ai-train=no) : il autorise la recherche IA mais refuse l'entraînement. Capture réelle de l'outil, adresse et nom du site floutés.Mais quand on frappe à la porte de la page d'accueil en se présentant comme un robot d'IA, le tableau change.
Où les robots d'IA sont bloqués
En nombre de sites, sur 100
7 sites dont le robots.txt est ouvert refusent pourtant les robots d'IA au niveau du serveur. Le navigateur reçoit la page, le robot reçoit une erreur 403 ou une page d'attente vide (code 202).
| Robot | Ce qu'il fait | Sites qui le refusent |
|---|---|---|
| GPTBot | Collecte pour l'entraînement des modèles d'OpenAI | 7 |
| ClaudeBot | Robot d'Anthropic (Claude) | 7 |
| PerplexityBot | Index de recherche de Perplexity | 5 |
| OAI-SearchBot | Recherche de ChatGPT | 0 |
Deux enseignements :
- Le propriétaire ne le voit pas. S'il ouvre son robots.txt, tout est autorisé. Le filtrage se fait plus haut, dans une protection anti-robots de l'hébergeur, une extension de sécurité ou un pare-feu applicatif. 5 des 7 sites concernés sont des agences immobilières, dont 4 répondent exactement de la même façon, ce qui laisse penser qu'elles partagent le même prestataire.
- Aucun ne refuse OAI-SearchBot. Ces sites restent lisibles pour la recherche de ChatGPT, mais pas pour Perplexity ni pour Claude. Nous ne savons pas pourquoi ce robot passe : sans doute une liste d'exceptions dans la protection. Mais c'est une visibilité à moitié, décidée par un réglage que l'entreprise n'a probablement jamais vu.
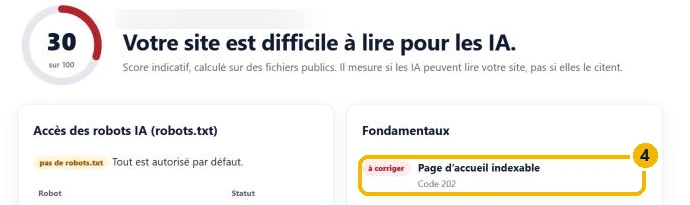
Deux autres sites n'ont répondu à aucune de nos requêtes automatisées, même présentées comme un navigateur : impossible de dire s'il s'agit d'une protection ou d'une panne, ils ne sont donc pas comptés parmi les 7. Nous avons vécu le même problème sur un de nos propres sites : jusqu'au 12 novembre 2026, le réglage des robots d'IA de Cloudflare y bloquait PerplexityBot, alors que le robots.txt était ouvert.
Un robots.txt ouvert ne prouve rien. Ce qui compte, c'est ce que reçoit le robot quand il frappe à la porte.
Résultat 4 : des entreprises sans identité pour les IA
Les données structurées (JSON-LD) disent aux machines qui est l'entreprise, ce qu'elle fait, où elle est et où trouver ses profils officiels. C'est ce qui aide une IA à relier votre nom à votre métier et à votre ville.
Ce que disent les données structurées de la page d'accueil
En nombre de sites, sur 100
- 22 sites n'ont aucune donnée structurée sur leur page d'accueil.
- 16 autres en ont, mais aucun type ne décrit l'entreprise : le balisage se limite au site, à la page ou au fil d'Ariane (WebSite, WebPage, BreadcrumbList), souvent le réglage de base d'une extension SEO.
- Moins d'un site sur deux relie son entreprise à ses profils officiels (
sameAs: Google Business Profile, LinkedIn, annuaire de la profession). - 3 sites sur 100 seulement déclarent leurs spécialités avec knowsAbout. Quand quelqu'un demande à une IA « un expert-comptable spécialisé en professions libérales à Bordeaux », c'est pourtant exactement l'information qui fait la différence.
Résultat 5 : les bases oubliées
Rien de spectaculaire ici, mais ces oublis coûtent des points faciles :
- 14 % des pages d'accueil n'ont pas de meta description, et 5 % n'ont pas de balise title lisible.
- 15 % n'ont pas de sitemap trouvable (ni déclaré dans le robots.txt, ni à l'adresse habituelle).
- 9 % ne déclarent pas la langue de la page.
- 6 sites ne répondent pas sans « www » : l'adresse
entreprise.frne mène nulle part, seulewww.entreprise.frfonctionne. Un humain s'en sort, un robot qui suit un lien sans www tombe dans le vide. - 1 site sur 100 publie la ligne
Content-Signaldans son robots.txt, la nouvelle façon de dire aux IA ce qu'elles ont le droit de faire du contenu (recherche, réponses, entraînement).
Les limites de l'étude
Une étude honnête dit ce qu'elle ne mesure pas.
- 100 sites, ce n'est pas toute la France. Les chiffres décrivent des PME bien placées sur des recherches commerciales dans de grandes villes. Des sites moins visibles ont sans doute des scores plus bas.
- Le test du pare-feu imite les robots par leur nom. Les vrais robots d'IA arrivent aussi depuis des adresses IP connues, que certaines protections vérifient. Notre test détecte un filtrage par nom de robot ; il ne voit pas tout ce que vit le vrai robot, dans un sens comme dans l'autre.
- Lisible ne veut pas dire cité. Nous avons mesuré l'accès, pas les citations. Être lisible ne garantit pas d'être recommandé par une IA, mais être illisible garantit d'être ignoré. Le lien entre score et citations réelles fera l'objet d'un prochain article.
- Une photo, pas un film. Toutes les mesures datent du 13 novembre 2026. Nous referons la même mesure dans quelques mois pour voir ce qui bouge.
Plan d'action en 4 étapes pour dépasser 90 sur 100
Dans l'ordre, du plus coûteux à ignorer au plus simple à faire :
- Vérifiez ce que reçoivent les robots, pas seulement votre robots.txt. Regardez les réglages de votre hébergeur, de votre extension de sécurité ou de votre pare-feu (chez Cloudflare : la gestion des robots d'IA). Laissez passer au minimum OAI-SearchBot, PerplexityBot et ClaudeBot, les robots qui servent la recherche et les réponses. Vous pouvez refuser l'entraînement (GPTBot, CCBot) sans toucher à votre visibilité dans les réponses.
- Publiez un llms.txt et relisez-le. Un titre au nom de l'entreprise, une phrase de résumé, 5 à 15 liens vers les pages qui répondent aux questions de vos clients. Notre générateur gratuit le prépare en 2 minutes.
- Donnez une identité à votre entreprise. Sur la page d'accueil, un bloc JSON-LD
OrganizationouLocalBusinessavec le nom, l'adresse, les profils officiels (sameAs) et les spécialités (knowsAbout). - Réglez les bases. Un sitemap déclaré dans le robots.txt, une meta description sur chaque page importante, la langue déclarée, et une adresse qui fonctionne avec et sans www.
Pour vérifier où vous en êtes, passez votre site dans le vérificateur : il applique exactement le barème de cette étude, et vous saurez en 10 secondes si vous êtes dans les 50 % bloqués à 85.
Votre site est-il dans les 81 % ?
Testez-le gratuitement avec le vérificateur de l'étude. Si vous préférez que ce soit fait pour vous : llms.txt, réglage des robots d'IA, données structurées et rapport avant/après, en 5 jours ouvrés. Et pour savoir si ChatGPT, Perplexity et Copilot vous citent vraiment, je pose 5 questions de vos clients à ces IA et je vous envoie le résultat sous 7 jours, gratuitement.
Questions fréquentes
Quelle part des sites de PME a un fichier llms.txt ?
Dans notre échantillon de 100 sites de PME françaises mesuré le 13 novembre 2026, 19 avaient un fichier llms.txt, soit 81 % sans. Les éditeurs de logiciels sont les plus équipés (10 sur 25), les agences immobilières les moins (2 sur 25).
Les PME bloquent-elles les robots d'IA dans leur robots.txt ?
Presque jamais : 1 site sur 100 bloquait un robot d'IA dans son robots.txt. En revanche, 7 sites dont le robots.txt était ouvert refusaient GPTBot et ClaudeBot au niveau du serveur, par un pare-feu ou une protection de l'hébergeur.
Comment savoir si mon pare-feu bloque les robots d'IA ?
Lire le robots.txt ne suffit pas. Il faut regarder les réglages du pare-feu ou de l'hébergeur (par exemple la gestion des robots chez Cloudflare), les journaux du serveur, ou demander la page d'accueil avec le user-agent d'un robot d'IA et comparer la réponse avec celle d'un navigateur.
Un bon score sur le vérificateur garantit-il d'être cité par ChatGPT ?
Non. Le score mesure si le site est lisible par les robots d'IA. Être lisible ne garantit pas d'être cité, mais être illisible garantit d'être ignoré. La citation dépend aussi du contenu des pages et de la réputation de l'entreprise sur le web.
Les données de l'étude sont-elles disponibles ?
Les résultats sont publiés de façon agrégée et anonyme. Chaque entreprise peut mesurer son propre site avec le vérificateur gratuit, qui applique le même barème que l'étude.
Sources et références, consultées le 13 novembre 2026
- Maruo Studio : mesures de 100 sites de PME françaises, 13 novembre 2026, avec le vérificateur llms.txt.
- llmstxt.org : la proposition llms.txt, version 2.
- Google Search Central : les fonctionnalités d'IA de Google et votre site.
- OpenAI : les robots GPTBot, OAI-SearchBot et ChatGPT-User.
- Schema.org : la propriété knowsAbout.