En bref
- Le robots.txt ne décide pas de tout. Cloudflare filtre les visiteurs avant qu'ils arrivent sur votre site. Un robot refusé à l'entrée ne lit même pas votre robots.txt.
- Ce n'est pas théorique. Dans notre étude de 100 sites de PME, 2 des 21 sites sur Cloudflare refusaient des robots d'IA alors que leur robots.txt était ouvert. Notre propre blog témoin bloquait Perplexity jusqu'au 12 novembre 2026.
- Le réglage clé s'appelle AI Crawler and Agent access policies. Il range les robots en trois familles : Search, Agent et Training.
- Notre conseil : Search et Agents sur « Allow ». Training selon votre choix : le refuser ne vous retire pas des réponses de recherche.
- Vérifiez par un test, pas en lisant un écran : 4 requêtes, 2 minutes.
Le problème : une porte fermée avant le robots.txt
Quand un robot visite votre site, deux contrôles se suivent.
- D'abord le pare-feu. Cloudflare, ou la protection de votre hébergeur, regarde qui arrive. Il peut laisser passer, demander une vérification ou refuser avec une erreur 403.
- Ensuite le robots.txt. Seulement si le robot est entré. Il lit vos consignes et décide de les suivre.
Le robots.txt est donc une affiche sur la porte. Le pare-feu, c'est le vigile devant. Si le vigile refuse l'entrée, l'affiche ne sert à rien.
Le piège, c'est que le propriétaire du site ne voit que l'affiche. Il ouvre son robots.txt, lit « Allow », et pense que tout va bien. Les outils de vérification classiques font pareil : ils lisent le fichier, ils ne demandent pas au vigile.
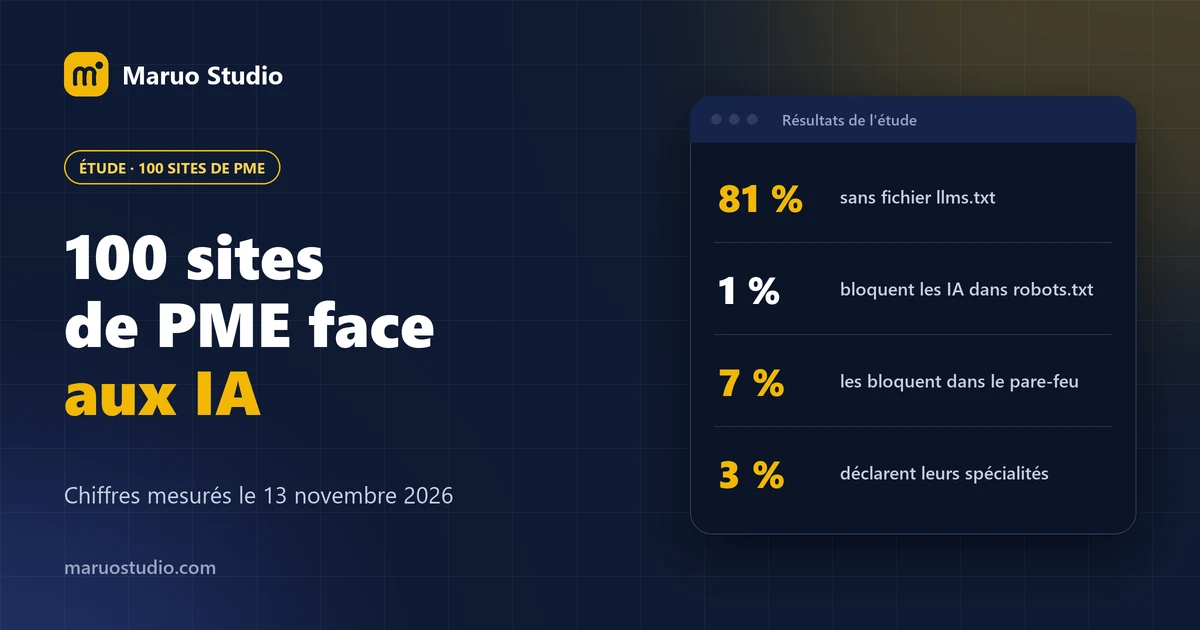
Nous l'avons mesuré sur 100 sites de PME françaises le 13 novembre 2026 :
| Constat | Sites |
|---|---|
| Bloquent un robot d'IA dans leur robots.txt | 1 sur 100 |
| Refusent des robots d'IA au niveau du serveur, robots.txt ouvert | 7 sur 100 |
| … dont sites passant par Cloudflare | 2 sur 21 |
| Sites sur Cloudflare qui publient la ligne Content-Signal | 0 sur 21 |
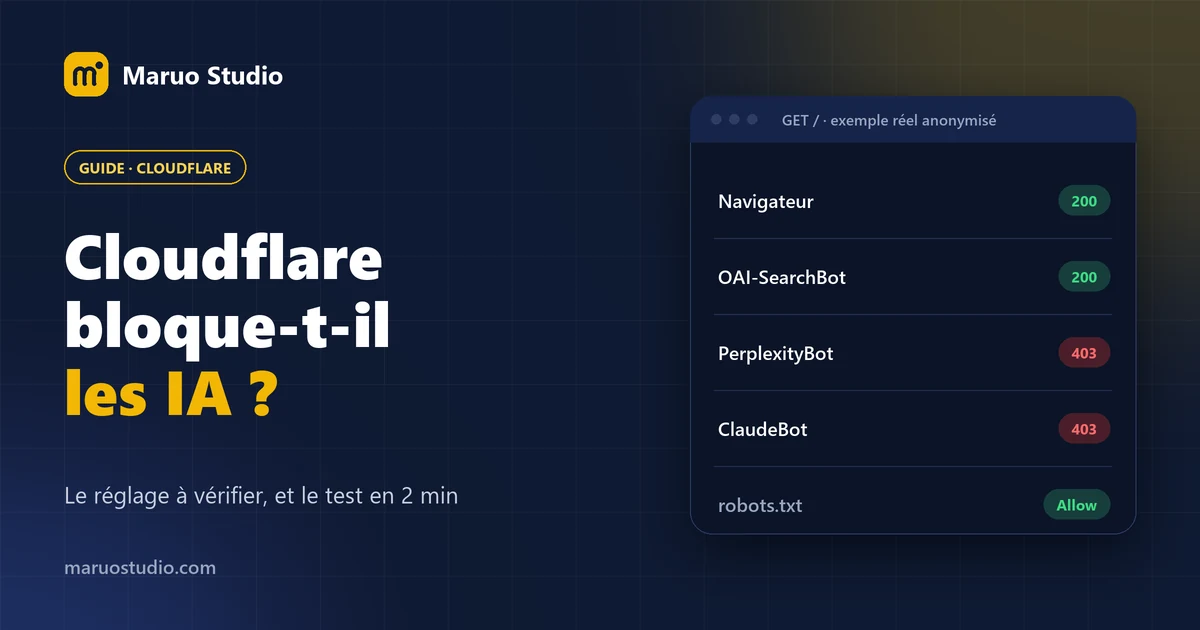
Les deux sites sur Cloudflare répondent normalement à un navigateur et au robot de recherche de ChatGPT (OAI-SearchBot). Mais ils renvoient une erreur 403 à GPTBot et à ClaudeBot, et l'un des deux aussi à PerplexityBot. Résultat : visibles dans ChatGPT, invisibles pour Perplexity ou Claude. Sans l'avoir décidé.
Ce qui nous est arrivé
Nous ne racontons pas ça de loin. Nous suivons chaque mois un blog témoin, lancé de zéro, pour tester nos méthodes. Chaque mois, nous posons les mêmes 5 questions à Perplexity. Résultat début novembre : 0 citation sur 5.
Le 12 novembre 2026, en creusant, nous avons trouvé la cause. Le robots.txt du blog était grand ouvert. Mais dans Cloudflare, le réglage des robots d'IA bloquait PerplexityBot sur tout le site. Et les agents qui lisent une page à la demande d'un utilisateur (Claude-User, Perplexity-User) recevaient « Your request was blocked » sur l'accueil et les articles.
La correction a pris trente secondes : passer Search, Training et Agents sur « Allow », puis retester. Tous les robots d'IA ont alors reçu la page normalement. Nous verrons au relevé du 1er décembre si Perplexity commence à citer le blog. Nous publierons le chiffre, quel qu'il soit.
Trente secondes pour corriger, plusieurs semaines sans le savoir. C'est tout le problème de ce réglage.
Les trois familles de robots d'IA
Depuis juillet 2026, Cloudflare ne raisonne plus robot par robot, mais par comportement. Il range le trafic d'IA en trois familles, que vous réglez séparément (documentation Cloudflare) :
- Search : indexe vos pages pour répondre plus tard aux questions. Exemples : OAI-SearchBot (ChatGPT), PerplexityBot, Claude-SearchBot. Si vous bloquez : vous sortez des réponses de ces moteurs.
- Agent : lit une page en direct, quand un utilisateur le demande. Exemples : ChatGPT-User, Perplexity-User, Claude-User. Si vous bloquez : l'IA ne peut pas ouvrir votre page quand un client lui donne votre lien ou lui pose une question sur vous.
- Training : collecte des textes pour entraîner les modèles. Exemples : GPTBot, ClaudeBot, CCBot. Si vous bloquez : vos textes ne servent plus à l'entraînement.
Les éditeurs eux-mêmes séparent ces usages. OpenAI explique par exemple que ses robots sont réglables indépendamment : on peut autoriser OAI-SearchBot pour apparaître dans la recherche de ChatGPT et refuser GPTBot pour l'entraînement (documentation OpenAI). C'est ce qui rend un réglage fin possible.
Pour chaque famille, Cloudflare propose quatre actions : Block (bloquer partout), Block on pages with ads (bloquer seulement sur les pages avec publicité), Allow (ne pas bloquer) et, pour Training uniquement, Disallow (refuser par une consigne dans le robots.txt).
Quel est le réglage par défaut ?
Honnêtement : ça dépend. La documentation de Cloudflare indique que les trois familles sont sur « Allow » par défaut pour les nouveaux domaines. Mais son journal des changements annonçait, pour les domaines ajoutés à partir du 15 septembre 2026, un blocage de Training et Agent sur les pages avec publicité. Et un domaine plus ancien garde les réglages choisis à l'époque, parfois par quelqu'un d'autre, parfois en cochant une case à l'inscription.
Conclusion pratique : ne supposez rien, allez voir.
Les quatre endroits qui peuvent bloquer
Sur Cloudflare, un robot d'IA peut être arrêté à quatre endroits différents. Il faut les vérifier tous.
- Les politiques d'accès des robots d'IA (AI Crawler and Agent access policies). Le réglage par familles décrit plus haut. C'est le plus fréquent, et celui qui nous a piégés.
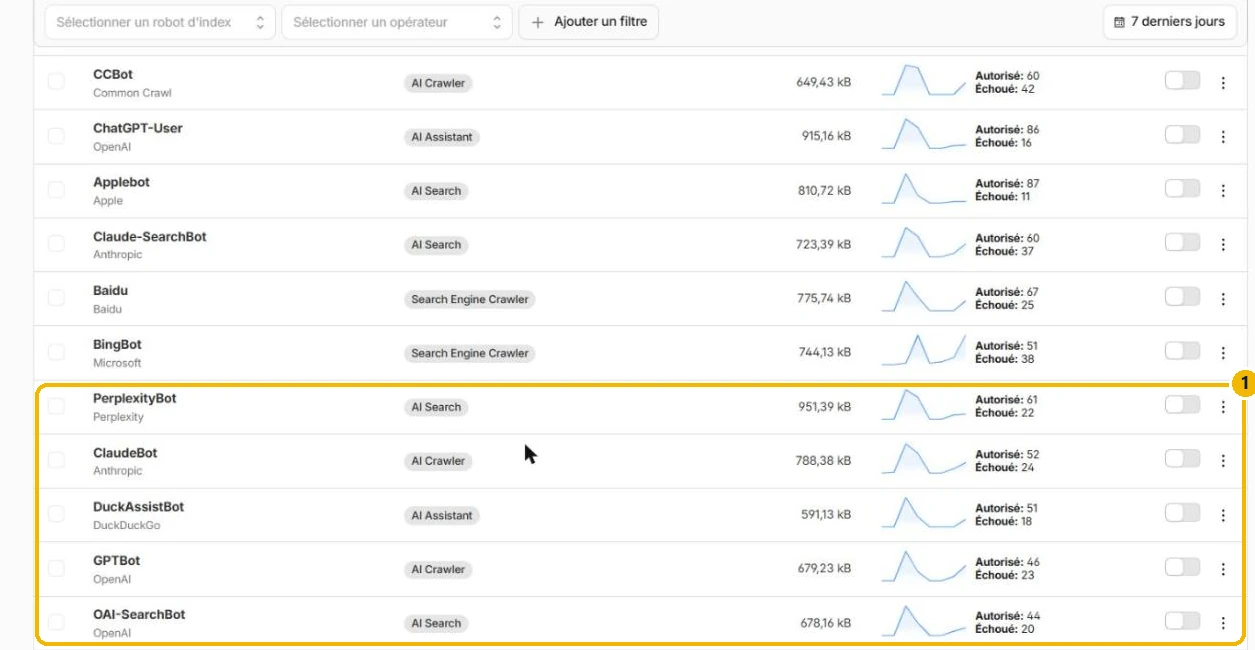
- AI Crawl Control, onglet Crawlers. Il permet de bloquer un robot précis, en plus des familles. Il affiche aussi, pour chaque robot, le nombre de requêtes acceptées et refusées. C'est le meilleur tableau de bord pour voir qui passe (documentation AI Crawl Control).
- Les règles personnalisées du pare-feu (WAF custom rules). Un prestataire a pu y ajouter une règle du type « bloquer tout ce qui contient bot ». AI Crawl Control y crée aussi sa propre règle. Lisez chaque règle qui parle de user-agent.
- La protection anti-robots générale (Bot Fight Mode). Elle vise les robots malveillants, mais peut aussi gêner des robots légitimes. Si vos tests échouent alors que tout le reste est ouvert, regardez de ce côté.
Un cinquième point ne bloque pas mais réécrit : le robots.txt géré par Cloudflare (Bot Preference Sync, qui remplace l'ancien « managed robots.txt »). S'il est actif, Cloudflare ajoute ses propres lignes à votre robots.txt. Ouvrez votresite.fr/robots.txt dans un navigateur pour voir ce qui est réellement servi, et pas seulement le fichier que vous avez écrit.
Le réglage conseillé, pas à pas
Pour une PME qui veut être recommandée par les IA, voici ce que nous conseillons, et ce que nous avons fait sur nos propres sites. Les noms des menus sont ceux de l'interface anglaise de Cloudflare, qui changent parfois de place.
- Ouvrez le tableau de bord Cloudflare et choisissez votre domaine.
- Allez dans Security › Settings, filtrez sur Bot traffic, puis ouvrez AI Crawler and Agent access policies.
- Réglez Search sur Allow. C'est la condition pour apparaître dans les réponses de ChatGPT, Perplexity et Claude.
- Réglez Agents sur Allow. Sinon, quand un client demande à une IA « que vaut cette entreprise ? », elle ne peut pas ouvrir votre page.
- Pour Training, choisissez. Allow si vous voulez que vos textes nourrissent les modèles (c'est notre choix : plus une IA connaît votre entreprise, mieux elle en parle). Disallow si vous préférez garder vos textes pour vous. Les deux sont défendables.
- Dans AI Crawl Control › Crawlers, vérifiez qu'aucun robot de recherche ou d'agent n'est sur Block.
- Dans Security › WAF › Custom rules, relisez toute règle qui vise un user-agent.
- Enregistrez, puis testez (section suivante). Un réglage non testé n'est qu'une supposition.
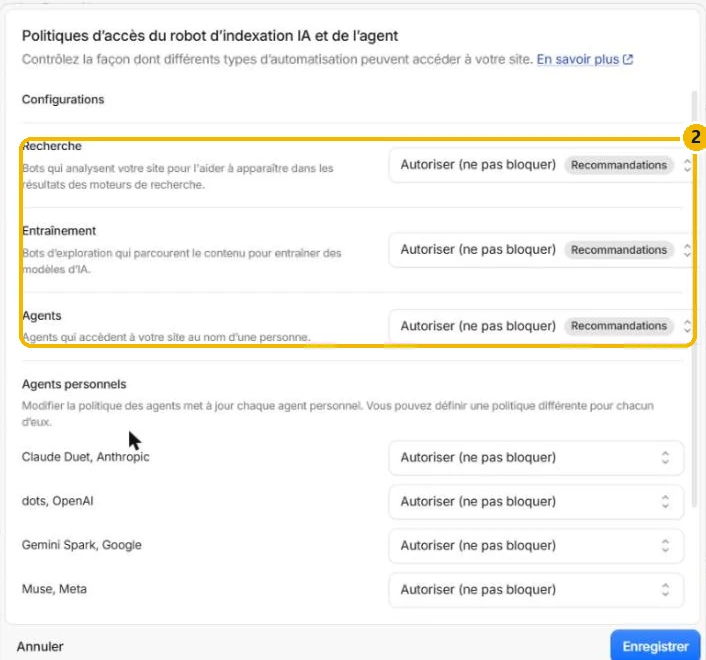
Ces réglages par familles sont disponibles sur tous les plans, gratuit compris, d'après le journal des changements de Cloudflare. Sur le plan gratuit, la détection repose sur le nom que le robot annonce (son user-agent).
Vérifier en 2 minutes
Le principe : demander votre page d'accueil quatre fois, en se présentant chaque fois sous un nom différent, et comparer les réponses. Si le navigateur reçoit la page et un robot reçoit une erreur, quelque chose filtre les IA.
Sur Windows, ouvrez PowerShell ; sur Mac, le Terminal. Remplacez votresite.fr et lancez ces quatre lignes, une par une :
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0" https://votresite.fr/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (compatible; OAI-SearchBot/1.0; +https://openai.com/searchbot)" https://votresite.fr/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (compatible; PerplexityBot/1.0; +https://perplexity.ai/perplexitybot)" https://votresite.fr/
curl -s -o /dev/null -w "%{http_code}\n" -A "Mozilla/5.0 (compatible; ClaudeBot/1.0; [email protected])" https://votresite.fr/
Sous Windows, écrivez curl.exe au lieu de curl, et NUL au lieu de /dev/null.
Chaque ligne affiche un nombre :
| Code | Ce que ça veut dire |
|---|---|
| 200 | La page est servie. C'est ce que vous voulez voir quatre fois. |
| 301 ou 302 | Redirection (vers www ou https). Ajoutez -L à la commande pour la suivre. |
| 403 | Accès refusé. Si le navigateur reçoit 200, un réglage bloque ce robot. |
| 202, 429 ou 503 | Page d'attente, limite de débit ou vérification anti-robot. Le robot ne reçoit pas votre contenu. |
Une limite à connaître : ce test imite les robots par leur nom. Les vrais robots arrivent aussi depuis des adresses connues, que Cloudflare peut vérifier. D'après sa documentation, chaque politique s'applique aux robots vérifiés et à ceux qui annoncent le même nom sans être vérifiés : le test reflète donc bien le réglage. Mais pour une certitude, regardez aussi la colonne des requêtes refusées dans AI Crawl Control › Crawlers, qui compte les vraies visites.
Pas envie d'ouvrir un terminal ? Notre vérificateur gratuit contrôle le robots.txt, le sitemap, les données structurées et le llms.txt. Il ne teste pas encore le pare-feu : pour ce point, les quatre commandes ci-dessus restent la méthode la plus sûre.
Bonus : dire ce que les IA ont le droit de faire
Une fois la porte ouverte, vous pouvez dire aux IA ce qu'elles ont le droit de faire de votre contenu. C'est le rôle de la ligne Content-Signal, proposée par Cloudflare (contentsignals.org), à placer dans le robots.txt, dans le groupe User-agent: * :
User-agent: *
Content-Signal: search=yes, ai-input=yes, ai-train=yes
Allow: /search: apparaître dans les résultats de recherche ;ai-input: servir de source pour les réponses des IA ;ai-train: servir à l'entraînement. Metteznosi vous refusez l'entraînement, sans toucher aux deux autres.
Aucun des 21 sites sur Cloudflare de notre étude ne publie cette ligne. Elle fait partie des points vérifiés par le diagnostic « Agent readiness » de Cloudflare : sur maruostudio.com, l'ajouter a fait passer ce diagnostic de 3 à 4 points sur 5.
Et si votre site n'est pas sur Cloudflare ?
Vous n'êtes pas à l'abri pour autant. Dans notre étude, 5 des 7 sites qui refusaient les robots d'IA n'étaient pas sur Cloudflare. La protection venait de l'hébergeur : quatre agences immobilières, sur la même configuration de serveur, renvoyaient aux robots d'IA une page d'attente vide au lieu de leur contenu.
Les coupables habituels hors Cloudflare :
- une protection anti-robots activée par l'hébergeur ou le prestataire du site ;
- une extension de sécurité WordPress qui bloque les user-agents inconnus ou « suspects » ;
- une limite de débit trop stricte, qui renvoie une erreur 429 aux robots.
Le test des quatre requêtes fonctionne pareil, quel que soit l'hébergement. Si un robot reçoit autre chose que 200, c'est à votre hébergeur ou à votre prestataire qu'il faut poser la question.
La porte est ouverte ? Passez à la suite
Une fois les robots d'IA autorisés, il reste à leur rendre le site facile à lire. Le Pack Visibilité IA s'en charge : llms.txt rédigé à la main, règles du robots.txt pour les robots d'IA, données structurées et rapport avant/après. Prix fixe, 5 jours ouvrés. Et pour savoir si les IA vous citent déjà, le test IA offert reste gratuit.
Questions fréquentes
Cloudflare bloque-t-il ChatGPT par défaut ?
Pas forcément, et c'est bien le problème : cela dépend de la date d'ajout du domaine, du plan et des réglages faits depuis. La documentation de Cloudflare indique que Search, Agents et Training sont autorisés par défaut, mais Cloudflare a annoncé des réglages plus restrictifs pour les nouveaux domaines à partir du 15 septembre 2026. Le seul moyen de savoir est d'ouvrir le réglage et de tester.
Si mon robots.txt autorise les robots d'IA, suis-je tranquille ?
Non. Le robots.txt est une consigne que les robots lisent. Cloudflare agit avant : il peut refuser la requête avec une erreur 403 sans que le robot lise jamais votre robots.txt. Dans notre étude de 100 sites, 1 seul bloquait un robot d'IA dans son robots.txt, mais 7 les refusaient au niveau du serveur.
Peut-on refuser l'entraînement des IA sans disparaître de leurs réponses ?
Oui, en grande partie. Les éditeurs séparent leurs robots : chez OpenAI, GPTBot sert à l'entraînement et OAI-SearchBot à la recherche de ChatGPT. Vous pouvez refuser le premier et autoriser le second. Dans Cloudflare, c'est la différence entre la catégorie Training et la catégorie Search.
Le réglage des robots d'IA est-il disponible sur le plan gratuit de Cloudflare ?
Oui. Selon le journal des changements de Cloudflare, les politiques par comportement (Search, Agent, Training) sont disponibles sur tous les plans, gratuit compris. Sur le plan gratuit, la détection repose sur le user-agent des robots.
Mon site n'est pas sur Cloudflare : suis-je concerné ?
Oui, le même problème existe ailleurs. Dans notre étude, 5 des 7 sites qui refusaient les robots d'IA n'étaient pas sur Cloudflare : la protection venait de l'hébergeur. Le test des user-agents décrit dans l'article fonctionne quel que soit l'hébergement.
Sources, consultées le 13 novembre 2026
- Cloudflare : AI Crawler and Agent access policies (familles, actions, valeurs par défaut).
- Cloudflare : AI Crawl Control, gestion des robots et onglet Crawlers.
- Cloudflare : journal des changements (1er juillet et 4 novembre 2026).
- OpenAI : GPTBot, OAI-SearchBot et ChatGPT-User.
- contentsignals.org : la ligne Content-Signal.
- Maruo Studio : étude de 100 sites de PME, mesures du 13 novembre 2026.